Une architecture Nextcloud haute disponibilité vise à maintenir le service lorsqu'un composant tombe en panne. En 2026, ajouter un second serveur web ne suffit pas : la base, Redis, le stockage, les sessions, les tâches planifiées et le répartiteur de charge doivent suivre la même logique. Sinon, la plateforme possède simplement deux points de panne au lieu d'un.
Ce guide propose une architecture de référence, explique les dépendances à rendre redondantes et décrit les tests à effectuer avant la production. Pour revoir le rôle de Files, des applications et des services associés, commencez par le guide complet de Nextcloud.
Que signifie réellement la haute disponibilité pour Nextcloud ?
La haute disponibilité réduit l'interruption provoquée par la perte d'un serveur, d'un processus ou d'une liaison. Elle repose sur plusieurs exemplaires d'un service, un mécanisme de détection et une bascule vers un composant sain. Cette définition ne promet ni absence totale de panne, ni reprise instantanée dans toutes les situations.
Avant de dessiner un cluster, listez les incidents que l'architecture doit absorber. La panne d'un nœud applicatif n'a pas les mêmes conséquences que la corruption de la base, l'indisponibilité du stockage ou une erreur de mise à niveau. Fixez aussi la durée d'interruption tolérée et la quantité maximale de données pouvant être perdues. Ces objectifs permettent de choisir entre redondance locale, réplication entre zones ou simple restauration documentée.
La haute disponibilité ne remplace pas une sauvegarde. Deux bases répliquées peuvent reproduire une suppression ou une corruption. Un stockage distribué peut propager un fichier chiffré. Conservez donc des copies indépendantes et vérifiez leur restauration avec le guide de sauvegarde Nextcloud.
Une instance à serveur unique reste parfois le choix le plus rationnel. Si une interruption planifiée est acceptable et qu'une restauration testée respecte le besoin métier, la complexité d'un cluster peut coûter plus cher qu'elle ne protège. La haute disponibilité devient pertinente lorsque la collaboration, la synchronisation ou les applications connectées ne peuvent pas attendre la remise en service d'une machine.
Commencez par le scénario de panne
Une architecture n'est pas hautement disponible parce qu'elle contient plusieurs serveurs. Elle l'est seulement si la perte réelle d'un composant déclenche une bascule testée sans rendre les données incohérentes.
Quelle architecture de référence utiliser ?
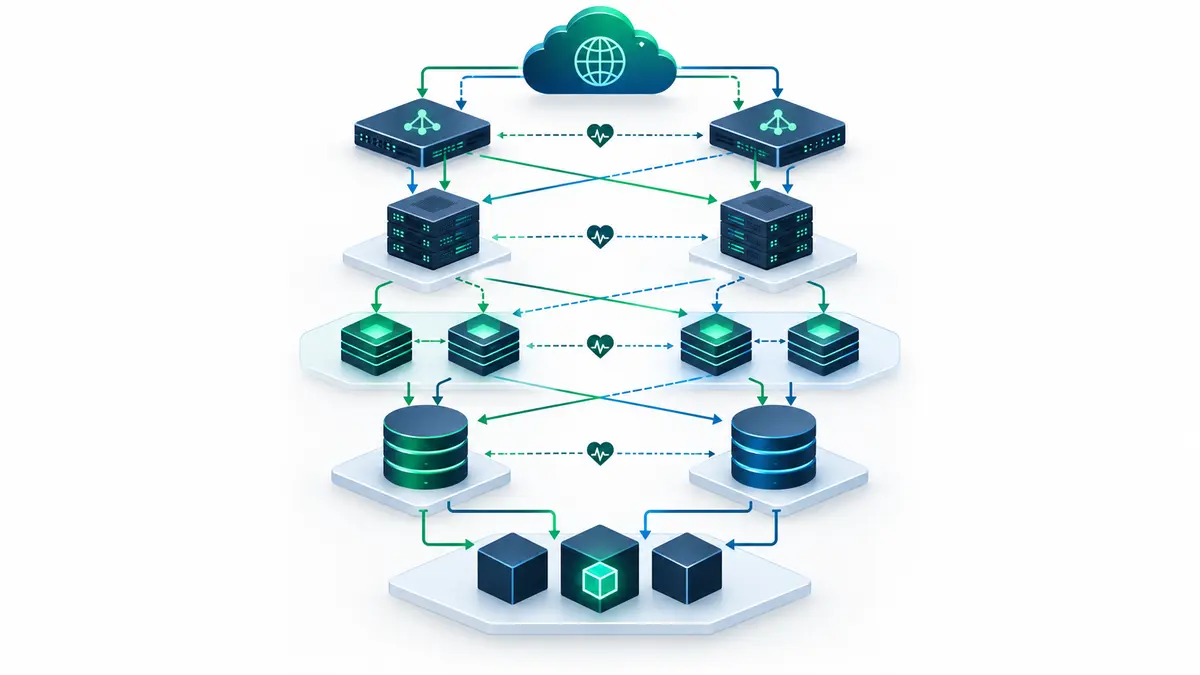
Le point d'entrée est un répartiteur de charge, ou load balancer, qui reçoit les connexions et les envoie vers plusieurs nœuds applicatifs. Il doit vérifier leur état et retirer automatiquement un serveur défaillant. Si ce répartiteur reste unique, il devient lui-même un point de panne. Un service managé ou une paire redondante est donc nécessaire pour couvrir ce risque.
Les nœuds applicatifs exécutent le même code Nextcloud, la même version, les mêmes applications et une configuration cohérente. Ils doivent partager ces éléments ou les recevoir par un déploiement synchronisé. Une mise à jour partielle peut envoyer deux versions différentes aux utilisateurs selon le nœud choisi.
Derrière cette couche, tous les serveurs doivent accéder aux mêmes états persistants : base de données, cache distribué, verrouillage de fichiers et contenu utilisateur. Le stockage peut reposer sur un système de fichiers partagé ou sur un stockage objet primaire conçu dès l'installation. Les journaux, métriques et alertes doivent enfin être centralisés afin qu'une bascule ne masque pas la panne initiale.
| Couche | Fonction | Condition de disponibilité |
|---|---|---|
| Répartiteur de charge | Distribuer les connexions | Au moins deux instances ou service redondant |
| Nœuds Nextcloud | Servir le web, WebDAV et les applications | Code, version et configuration identiques |
| Redis | Cache distribué, sessions selon le déploiement, verrouillage | Bascule Sentinel ou cluster pris en charge |
| Base de données | Conserver comptes, partages et métadonnées | Réplication, bascule et sauvegarde testées |
| Stockage | Conserver le contenu des fichiers | Accès commun, redondance et contrôle d'intégrité |
| Tâches de fond | Exécuter traitements et entretien | Planification contrôlée et supervision |
Comment rendre la base, Redis et le stockage disponibles ?
La base contient l'état logique de Nextcloud : utilisateurs, partages, index des fichiers, paramètres et données d'applications. Une réplication SQL ne garantit pas à elle seule la bascule des connexions. Le cluster doit présenter un point d'accès stable aux nœuds Nextcloud, détecter le serveur actif et éviter qu'une coupure réseau crée deux primaires divergents. Le moteur, le proxy SQL et le mécanisme d'élection doivent être validés ensemble.
Redis sert au cache distribué et au verrouillage transactionnel des fichiers. APCu reste un cache local à chaque processus PHP et ne partage rien entre plusieurs machines. Pour un cluster, le manuel Nextcloud 35 recommande APCu comme cache local et un backend partagé pour le cache distribué et le verrouillage. Il documente Redis Cluster ainsi qu'une réplication gérée par Sentinel avec le nouveau backend KeyValueCache. Tous les nœuds applicatifs doivent pointer vers le même serveur ou cluster, jamais vers leur propre localhost.
Le contenu des fichiers doit être accessible depuis tous les nœuds. Un système NFS ou distribué peut fournir un espace commun, à condition de mesurer sa latence, son verrouillage et son comportement lors d'une coupure. Le stockage objet primaire constitue une autre approche. Il doit être défini avant la mise en service, rester réservé à Nextcloud et être sauvegardé avec la base et la configuration.
Le guide Nextcloud avec stockage S3 détaille la différence entre stockage primaire et montage externe. Dans une architecture disponible, ce choix concerne aussi la reprise : le bucket ne suffit pas à reconstruire l'arborescence visible, car les noms et les métadonnées restent liés à la base.
La réplication ne valide pas la reprise
Testez la perte du primaire, puis une restauration depuis une copie indépendante. Une réplication verte peut cacher une erreur logique, un retard ou une configuration incapable de promouvoir le bon nœud.
Comment gérer sessions, verrouillage et tâches de fond ?
Le répartiteur doit transmettre correctement le nom d'hôte, le protocole HTTPS et l'adresse du client. Nextcloud doit connaître les proxys autorisés et les paramètres overwrite* adaptés à la topologie. Une erreur sur ces valeurs peut produire des boucles de redirection, des liens en HTTP ou des journaux remplis avec l'adresse du proxy au lieu de celle du client.
Les sessions PHP doivent rester valides lorsqu'une requête passe d'un nœud applicatif à un autre. Deux méthodes existent : maintenir temporairement un utilisateur sur le même serveur, ou stocker les sessions dans un backend commun. Si Redis est retenu comme stockage partagé des sessions PHP dans votre environnement, sa disponibilité devient directement liée aux connexions des utilisateurs.
Le verrouillage des fichiers doit lui aussi être partagé. Sans cache distribué, deux nœuds peuvent prendre des décisions incompatibles sur un même document. Configurez Redis selon le manuel de la version installée, puis testez des écritures simultanées depuis le navigateur, WebDAV et un client de synchronisation.
Pour les tâches de fond, utilisez cron, méthode recommandée par Nextcloud pour un serveur. Définissez clairement où le job s'exécute, comment un autre nœud prend le relais et comment une erreur déclenche une alerte. Une page web disponible ne signifie pas que les aperçus, nettoyages, notifications ou traitements d'applications continuent de fonctionner.
Ajoutez enfin les services annexes au périmètre. Talk, une suite bureautique, l'antivirus, la recherche ou un annuaire peuvent rester indisponibles alors que la page d'accueil fonctionne. Le plan de continuité doit préciser quels services sont indispensables et lesquels peuvent fonctionner en mode dégradé.
Quels tests réaliser avant la production ?
Commencez par une recette fonctionnelle avec tous les composants actifs : connexion, envoi, téléchargement, partage, édition, synchronisation et applications essentielles. Enregistrez les temps de réponse et les journaux. Ces mesures serviront de référence pendant les scénarios de panne.
Coupez ensuite un nœud applicatif sans prévenir le répartiteur. Vérifiez le temps nécessaire pour le retirer, le comportement des connexions déjà ouvertes et l'absence d'erreur côté client. Recommencez pendant un envoi de fichier et une édition. La simple réponse HTTP 200 d'une page de santé ne valide pas WebDAV ni les applications.
Testez séparément la perte du serveur Redis actif, la promotion de la base, l'indisponibilité temporaire du stockage et la panne du répartiteur. Pour chaque cas, relevez la durée, les erreurs visibles, les écritures acceptées et l'état après retour du composant. Vérifiez qu'aucune divergence n'apparaît dans les fichiers ou la base.
La mise à niveau mérite son propre exercice. La documentation Nextcloud impose de garder tous les nœuds sur la même version. Préparez une procédure qui retire les serveurs du trafic, déploie le même code et la même configuration, exécute l'étape de mise à niveau une seule fois, puis réintègre les nœuds après contrôle. Pour un changement d'infrastructure complet, le guide migrer Nextcloud vers un nouveau serveur couvre la préparation et le retour arrière.
Conservez une fiche de recette avec, pour chaque panne : résultat attendu, commande ou action, heure de début, durée de bascule, erreurs, contrôle des données et décision finale. Répétez ces tests après une modification du proxy, de Redis, de la base, du stockage ou de la méthode de déploiement.
Quand choisir un cluster ou un service géré ?
Un cluster Nextcloud demande plus que plusieurs machines. Il faut administrer le répartiteur, le déploiement synchronisé, le cache, la base, le stockage, les certificats, les sauvegardes et la supervision. L'équipe doit aussi pouvoir diagnostiquer une panne partielle, situation souvent plus difficile qu'un arrêt complet.
L'auto-hébergement convient lorsqu'une équipe maîtrise ces briques et accepte d'en tester la bascule. Un service géré réduit la charge d'exploitation, mais il faut vérifier le périmètre réel : architecture partagée ou dédiée, objectifs de disponibilité, sauvegardes, restauration, maintenance, support et services annexes. Le comparatif entre Nextcloud auto-hébergé et hébergé aide à répartir ces responsabilités.
Demandez des preuves plutôt qu'une mention « haute disponibilité ». Le fournisseur doit pouvoir expliquer les couches redondantes, les composants qui ne le sont pas, la fréquence des tests et le traitement d'une panne de zone. Si aucun objectif contractuel n'est défini, considérez les promesses de disponibilité comme des indications techniques, pas comme un engagement mesurable.
Conclusion
La haute disponibilité de Nextcloud dépend de toute la chaîne : répartiteur, nœuds applicatifs identiques, Redis, base, stockage et tâches de fond. Commencez par les interruptions réellement inacceptables, puis construisez chaque mécanisme de bascule autour de ces objectifs. Testez les pannes pendant des écritures, documentez les résultats et conservez des sauvegardes indépendantes. Un cluster non exercé reste une hypothèse. Une architecture plus simple, restaurable et surveillée peut être préférable lorsqu'elle répond déjà au besoin métier.
Découvrir l'offre Nextcloud GaprodArchitecture gérée, niveau de disponibilité à confirmer selon votre cahier des charges